経過報告:形を数で表すモデル(段階1〜3)
要約
形を数の並び(潜在ベクトル)に変え,また形に戻すモデルを4種類つくって比べました.どれも形はよく再現できます.ただし「同じ編集を別の形に移す」実験では大きな差が出ました.輪郭に沿って情報を持つ contour だけが,別の形で測った編集を足しても,ほぼ正しい突起を生やせました(誤差 9%).
前回の判定を見直します.前回は事前に決めた基準で gdrop を採用としました.しかし今回の実験で,gdrop では z_g を動かしても形がほとんど変わらないことがわかりました(突起の形の誤差 99.5%,つまり突起がほぼ出ない).潜在の数字だけを見る基準では足りず,実際に形に戻して確かめる基準が必要でした.
追記(同日):contour を改良しました(9節).「同じ編集なら,どの形の上でも同じ潜在の変化になる」よう学習させる損失を加えたところ,編集を移したときの誤差は 9% から 1.7% に下がり,直接符号化したときの限界(1.3%)にほぼ届きました.代わりに,編集の影響が少し広い範囲に広がりました.
追記(同日):段階2の予測器ができました(11節).編集前の潜在と編集の指定から,編集後の潜在を予測します.誤差は 1.3% で,編集後の形を直接符号化した場合(1.1%)に迫ります.高さを「土台の大きさに対する比」で指定する編集では,学習なしの方法(5.5%)より約4倍,実際の設計に近い「法線方向の押し出し」では約8倍正確でした.
1.このプロジェクトは何をしようとしているか
最終的な目標(IDO)は,物体の形を少し変えたとき,周りの流れがどう変わるかを予測することです.そのための準備として,形を「数の並び」で表す方法を作っています.形の変化(たとえば突起を付ける)が,数の並びの「決まった向きへの移動」として表せれば,その移動から流れの変化を予測しやすくなります.
そのために,数の並び(潜在)には次の性質を求めています.このあとの実験は,すべてこれを確かめるためのものです.
- 形を正確に再現できる 小さな突起(高さ 0.03)まで戻せること.
- 大きさに比例して動く 突起を2倍の高さにすると,潜在の移動も2倍になること.
- 同じ編集は同じ向き どの形に付けても,同じ突起なら潜在が同じ向きに動くこと.
- 足し算になる 突起 A と突起 B を両方付けた形が,A の移動+B の移動で表せること.
- 局所的 輪郭の一部だけを変える編集は,潜在の一部だけを変えること.
いまは3段階のうち段階1(形 ↔ 数)の実験です.流れの計算はまだ行っていません(後回し).
2.用語
- モデル
- 入力から出力を計算するプログラムで,中に調整できる数(パラメータ)を多数持つ.このプロジェクトでは「形を潜在に変え(符号化器),潜在から形に戻す(復号器)」もの(オートエンコーダ)を指す.
- 模型
- 「モデル」と同じ意味.英語の model の訳語で,報告の初版と打ち合わせではこちらを使っていた.現実のもの(ここでは形)を,扱いやすい形で写し取ったもの,という意味では両者は同じ.機械学習では「モデル」と書くのが普通なので,この報告では「モデル」に統一した.
- 学習
- 大量の例(形と,その正解の SDF)を見せ,出力が正解に近づくようにパラメータを少しずつ調整すること.1回の調整を1 step と数え,今回は 60,000 step(約30分)行った.
- 学習したモデル
- 学習を終えた時点のパラメータを保存したもの(チェックポイント).この報告の検査と図は,すべて学習したモデルに評価用の形を入れて計算した.
- パラメータ数
- モデルの中で学習によって決まる数の個数.今回のモデルは 90万〜140万個.大きいほど複雑な関係を表せるが,学習に時間がかかる.
- 符号化器・復号器
- 形(surfel の列)を潜在に変える部分が符号化器,潜在と平面上の点を受け取ってその点の SDF を返す部分が復号器.
- 検証用・評価用の形
- 学習に使っていない形.覚えた例だけでなく,初めて見る形にも通用するかを確かめるのに使う.
- 形 Ω
- 2次元の閉じた図形.中心から見てどの方向にも輪郭が1回だけある形(星状形状)に限っています.
- 編集
- 形に付ける突起(外向き)や凹み(内向き).位置 θ(角度),高さ h,幅 w で決まります.
- surfel(輪郭要素)
- 輪郭の上に並べた512個の点.各点は位置と向き(法線)を持ちます.モデルへの入力です.
- SDF(符号付き距離)
- 平面上の各点から輪郭までの距離.形の内側を負,外側を正とします.モデルはこれを出力し,値が0のところが輪郭です.
- 潜在(z)
- モデルが形を表すのに使う数の並び.このプロジェクトでは,形全体の要約 z_g(64個の数)と,場所ごとの情報 G の2種類があります.
- Δz
- 編集の前後での潜在の差.「編集が潜在空間で何に当たるか」を表します.
- cos 類似度
- 2つの矢印の向きがどれだけそろっているか.1 なら同じ向き,0 なら無関係(直交).
3.データを作る
3.1 学習用の形と編集
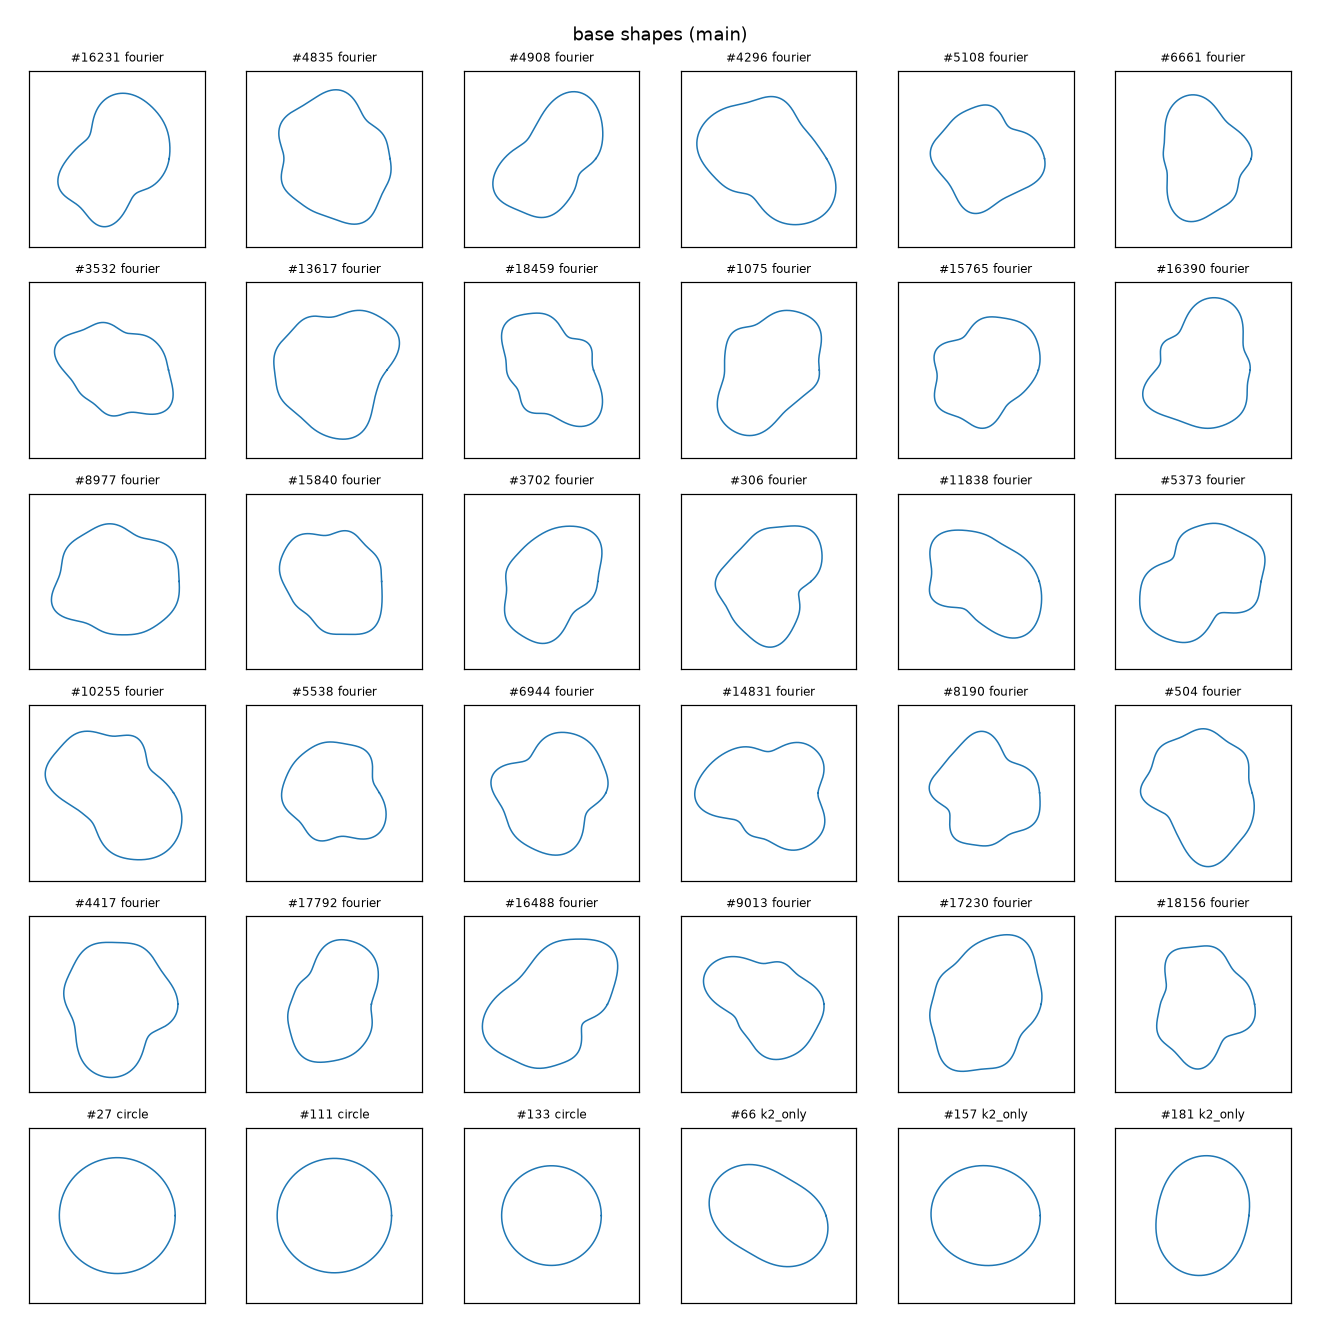
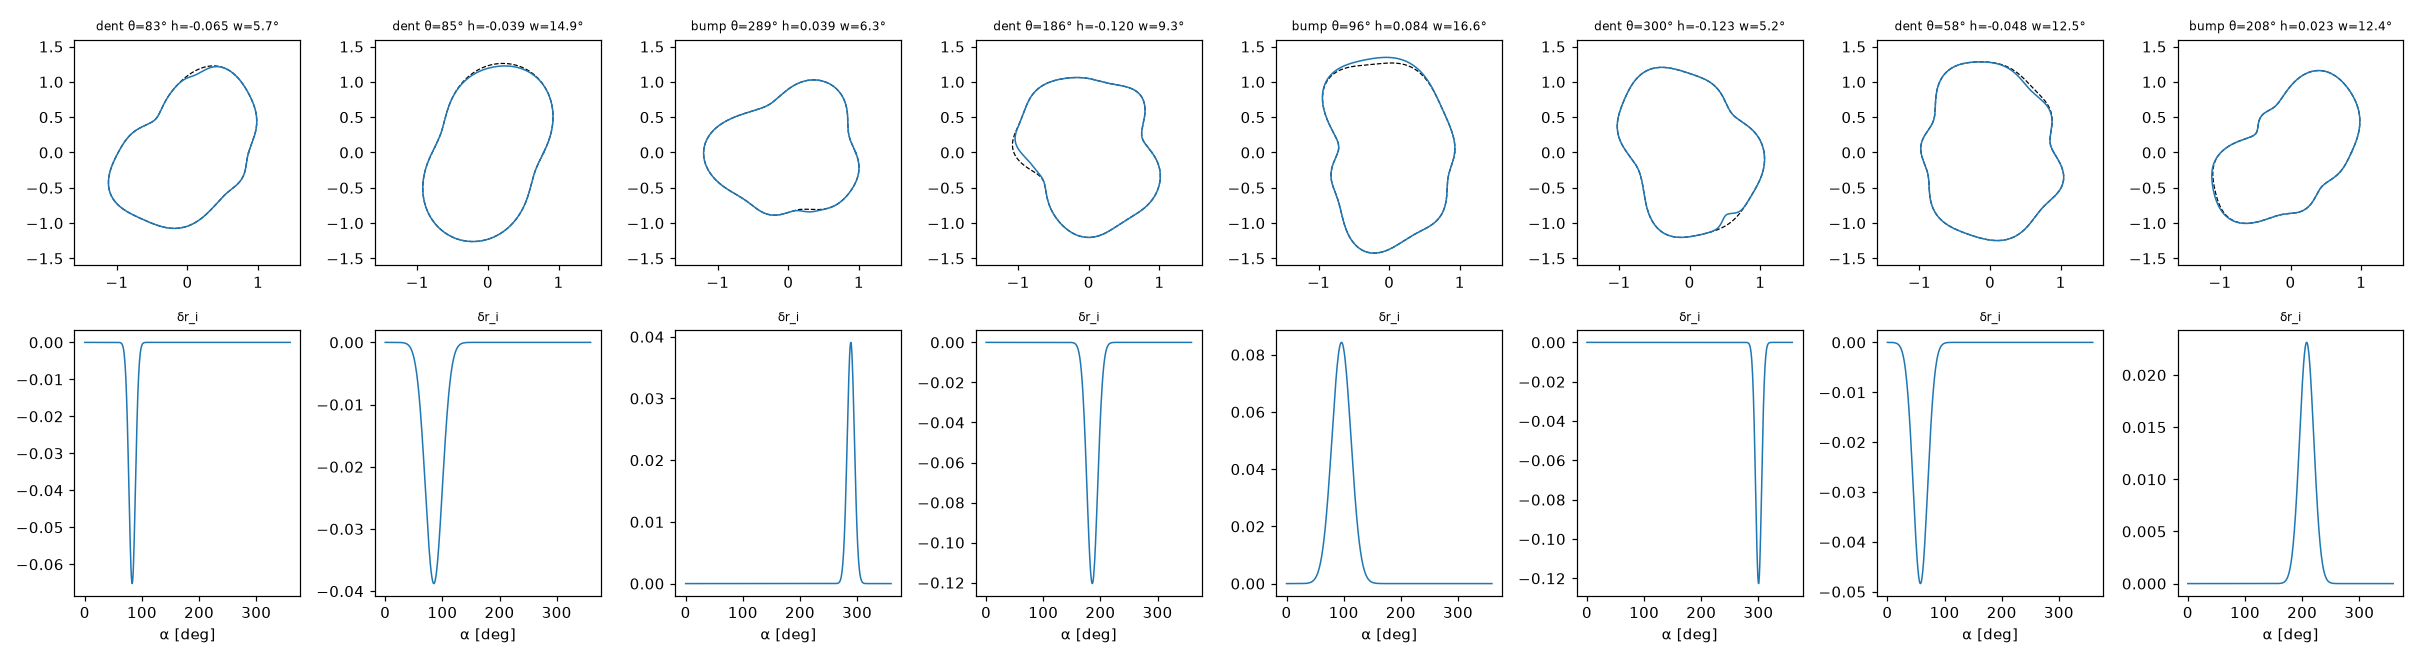
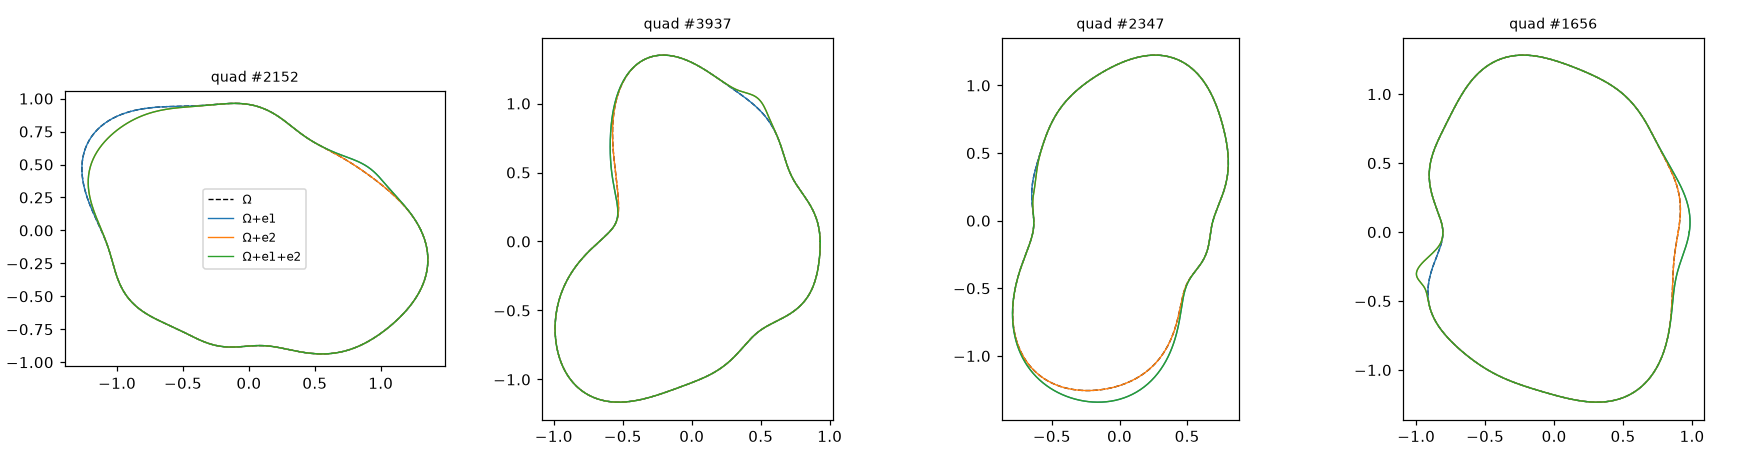
- 意図
「どんな編集をしたか」の正解がわかっている形をたくさん用意し,モデルに学ばせると同時に,潜在が編集をどう表すかを測れるようにする.
- 期待
形は多様だが,半径0.5〜1.5,急に曲がりすぎない,という制約を守る.編集の前後の差は,ちょうど付けた突起の分だけになる.
- 結果
基準形状 20,000 個に編集を付け,72,168 個の形と 56,224 組の編集ペア,4,056 組の4つ組を作った.基準形状の単位で学習90%・検証5%・テスト5%に分けた.法線の長さ,半径の制約,編集の前後の差,4つ組の足し算は,すべて誤差 1e-6 以下で検査に合格.
- 考察
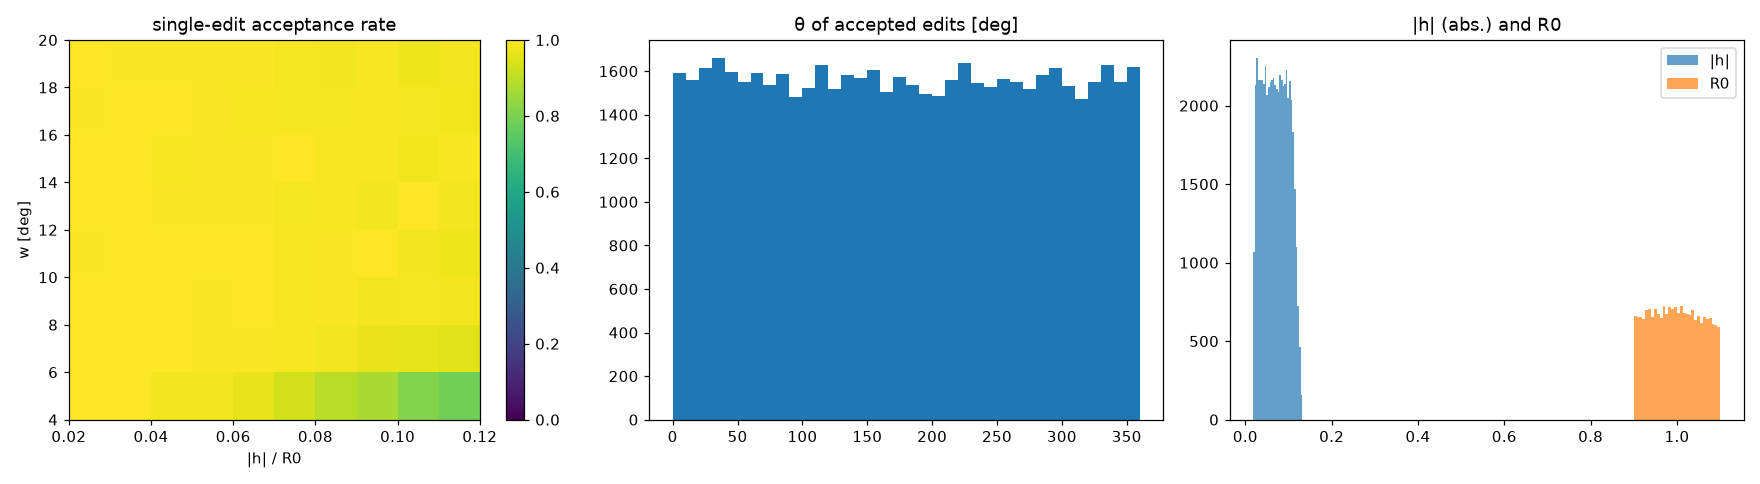
細くて高い突起(幅 6° 未満かつ高さ 0.10 超)は曲がりの制約で約3割が棄却され,やや少ない(図3-4).学習範囲の外を試すテスト(高さ,形の族)も作ったが,形の族のテストは学習用と見た目の差が小さく,外挿の試験としては弱い可能性がある.次の実験:モデルの候補が決まったら,外挿テストで性能が落ちるかを測る.
3.2 評価用の形(円+突起)
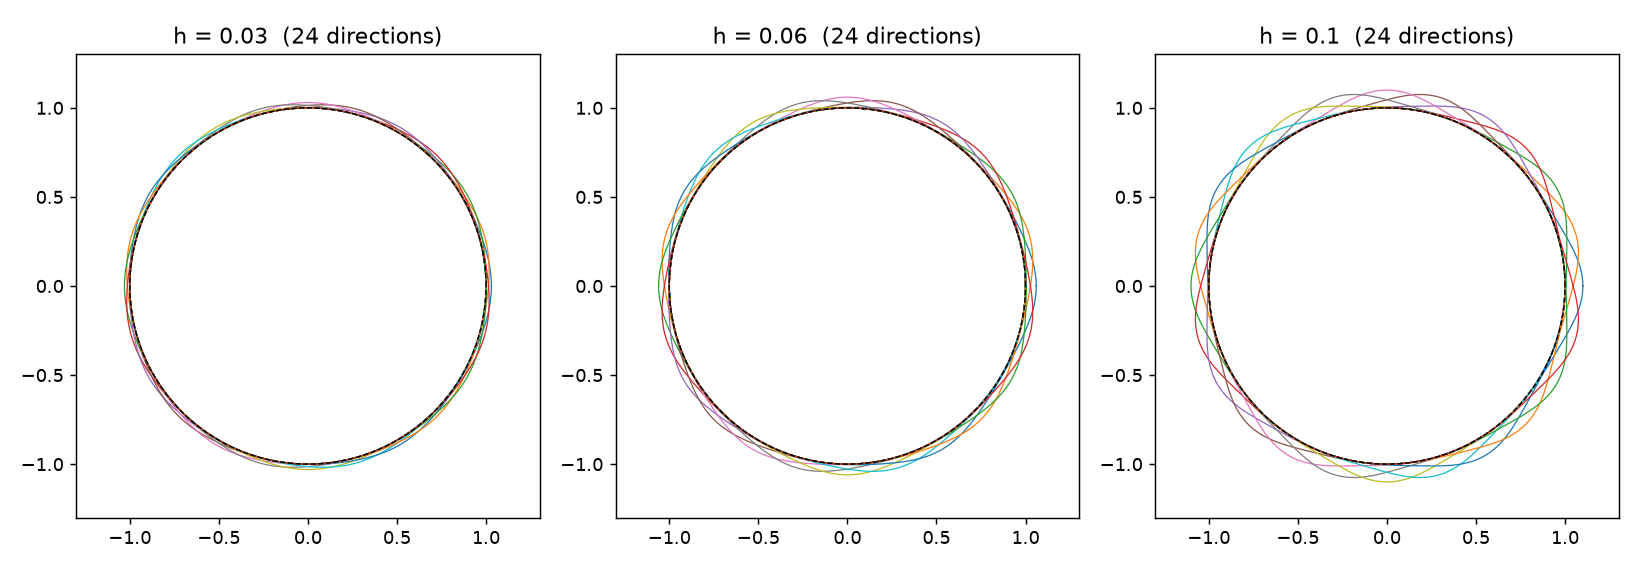
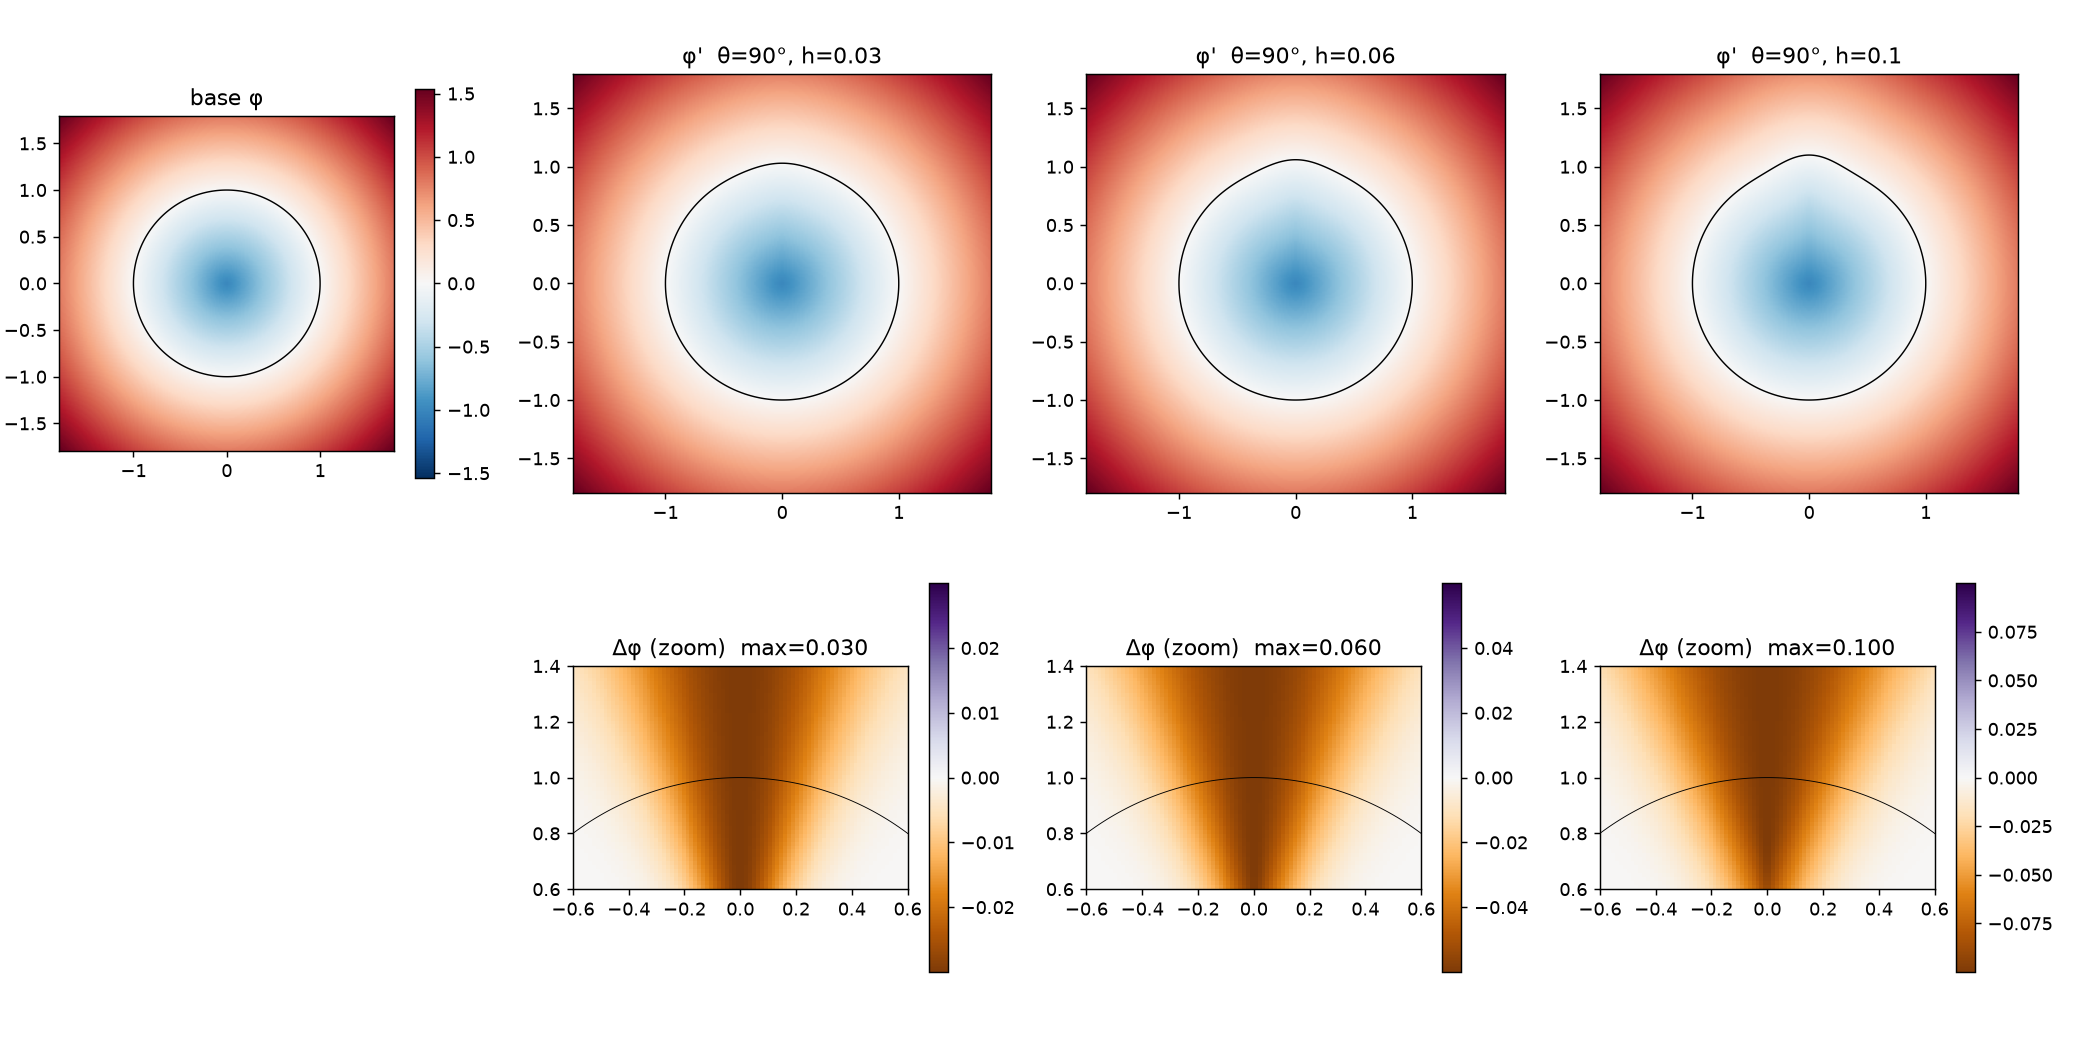
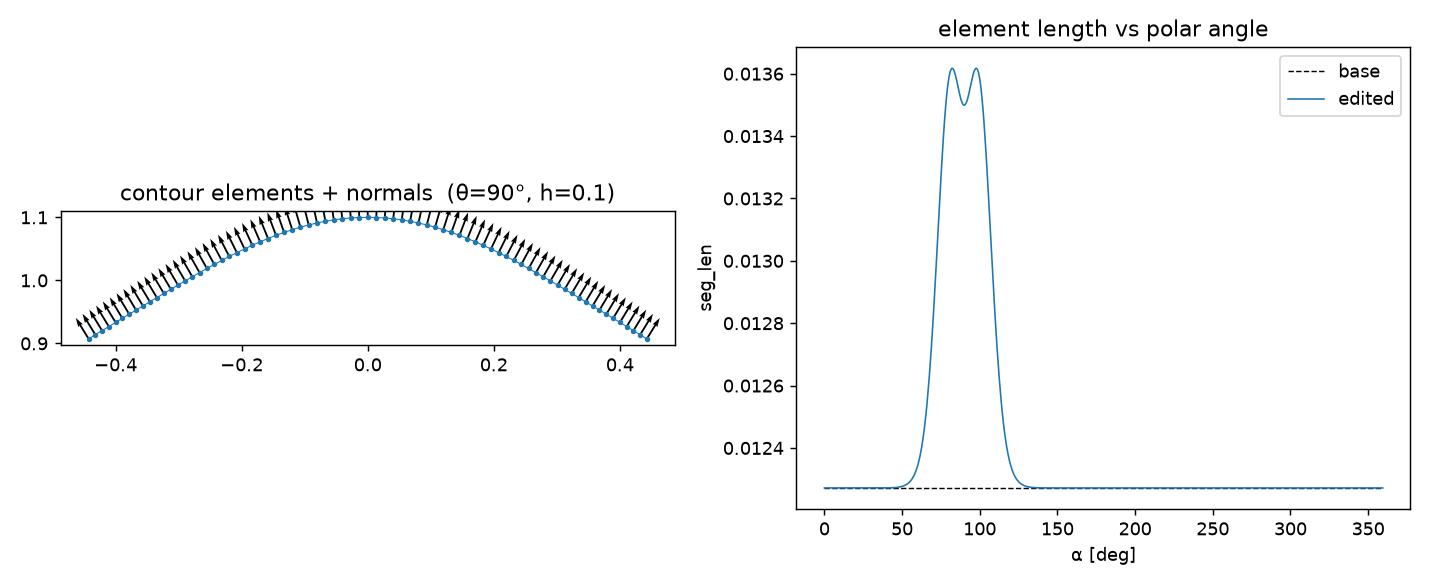
- 意図
学習には一切使わない「ものさし」を作る.突起の位置と高さを規則正しく振ってあるので,潜在の性質(比例するか,方向が一周するか)を見やすい.
- 期待
最小の突起(h=0.03)でも,SDF の格子(256×256)の上で見分けられる.
- 結果
最小の突起は格子の約2.1マス分の差になり,見分けられる(合格).一方,突起による SDF の変化は輪郭の外へ扇形に広がる(図3-6 下).
- 考察
SDF の差では「局所的か」を測れない(遠くまで広がるため).そこで局所性は,輪郭の上の変位や潜在の上で測ることにした(7.3節).
4.形を数に変えるモデル(4つの案)
| 案 | 何が違うか | ねらい(意図) |
|---|---|---|
| base | G(32×32 の格子)と z_g の両方を使う | 形の再現を最も正確にする.基準になる案. |
| global_only | G を使わず z_g だけ | 比べるための対照.数が少ないぶん,編集の表し方が素直になると予想. |
| contour | G を「輪郭に沿った64区間」にする | 同じ角度の突起が,どの形でも G の同じ場所に入るようにする. |
| gdrop | base と同じ構造だが,学習中に半分の確率で G を消す | G がなくても形を表せるよう z_g を鍛え,編集を z_g に入れる. |
- 意図
「正確な再現」と「素直な編集の表し方」を両立する構造を探す.最初の base と global_only の比較で,再現は base,編集の素直さは global_only が良いという食い違いが出たため,両方の良さを狙う2案(contour,gdrop)を加えた.
- 期待
contour と gdrop はどちらも,再現を base 並みに保ったまま,別の形でも同じ編集が同じ向きになる.
- 結果
5〜8節で示す.再現はどれも良好.編集の表し方は案によって大きく違った.
- 考察
比べる観点(判定の基準)は学習の前に決めた.ただし今回,その基準に穴があることがわかった(8節).
5.学習の経過
- 意図
4つのモデルがきちんと学習を終えたか(途中で止まったり,発散したりしていないか)を確かめる.
- 期待
どの曲線も右下がりで,最後に平らになる.再現の正確さは G を持つ案(base,contour,gdrop)が global_only より良い.
- 結果
4本とも順調に下がり,60,000 step で落ち着いた.最終の検証誤差は base が最も小さく,global_only が最も大きい(約4〜5倍).1本の学習は約24〜31分.
- 考察
学習時間を延ばしてもまだ少し下がる余地はあるが,比較には十分.G(場所ごとの情報)を持つと,細かい形を覚えやすいことが確かめられた.
6.形を正確に再現できるか
- 意図
潜在の性質を調べる前に,そもそも形を戻せるか(性質1)を確かめる.小さな突起が消えてしまうモデルでは,編集の議論ができない.
- 期待
どのモデルも輪郭は見た目で正解と重なる.誤差は最小の突起の高さ(0.03)より十分小さい.global_only は細部がやや甘い.
- 結果
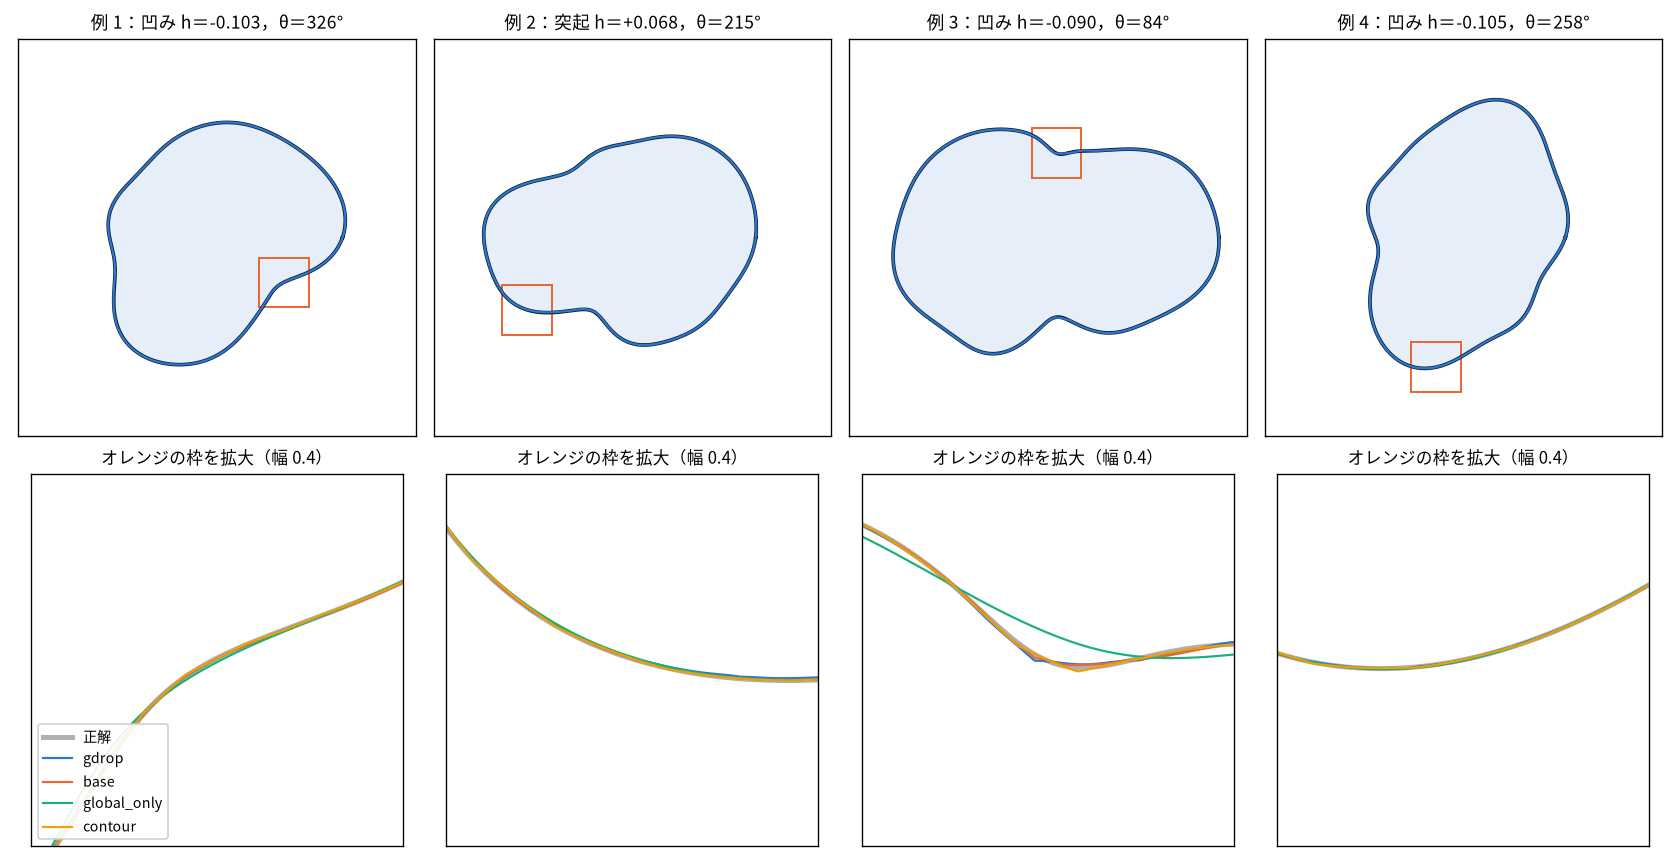
全体図ではどのモデルも正解と重なり見分けがつかない.拡大すると global_only だけ凹みの底が浅い(例3).表面の誤差は base 1.21×10⁻⁴,gdrop 1.47×10⁻⁴,contour 2.37×10⁻⁴,global_only 7.41×10⁻⁴.最小の突起に対して base は約1/250,global_only でも約1/40.gdrop で G を消して z_g だけで戻すと 1.07×10⁻³ に悪化した.
- 考察
再現は4案とも合格水準(global_only を除き目安 2.5e-4 以下).拡大図で輪郭が少し折れ線になる箇所があるのは,G を格子や区間の間で直線的に補間しているためと考えられる.gdrop の結果から,G があるモデルでは細部を G が受け持ち,z_g は大まかな形しか持たないことがわかる.これが7.6節の結果につながる.
7.潜在は編集をどう表しているか
ここからは,形の変化が潜在の上でどんな動きになるかを調べます.gdrop と global_only は z_g,base と contour は G で測りました(それぞれ編集の情報が入るはずの場所).
7.1 大きさに比例して動くか
- 意図
性質2を確かめる.突起の高さを 0.03,0.06,0.10 と変えたとき,潜在の移動量がそれに比例するかを見る.
- 期待
どの方向の突起でも,点が破線(原点を通る直線)の上にのる.
- 結果
4つとも破線にほぼ重なった.24方向でのばらつき(ひげ)も小さい.当てはめの決定係数は G で測った base 0.996,contour 0.9999,z_g で測った gdrop 0.9998,global_only 0.9999.
- 考察
「大きさに比例する」はどの案でも成り立っており,案を選ぶ決め手にはならない.なお base の z_g で測ると 0.963 に下がる.base では編集の情報が z_g ではなく G に入っているためで,どこで測るかが重要だとわかった.
7.2 方向の地図:突起の向きを一周させると潜在も一周するか
- 意図
突起の位置 θ を 0°→360° と一周させたとき,潜在の移動 Δz がどんな軌跡を描くかを目で見る.高次元の Δz を,主成分分析で最もよく表せる2次元に写した.
- 期待
θ の順に点が並び,滑らかな輪(ループ)を描く.高さを上げると輪が外に広がる.色(θ)は一周して元の色に戻る.
- 結果
z_g で測った gdrop と global_only は,きれいな輪になった(2次元で全体の約44%を表す).G で測った base と contour は2次元に収まる割合が約22%と低く,平面の図では軌跡が複雑に見える.
- 考察
G で表した編集は,場所ごとに別の成分を使う(局所的な)ため,少数の向きにまとまらない.これは悪いことではなく,局所性の裏返しである.平面の図だけで良し悪しは判断できないので,数値(7.4〜7.6節)と合わせて見る.
7.3 局所的か:突起は潜在のどこを変えるか
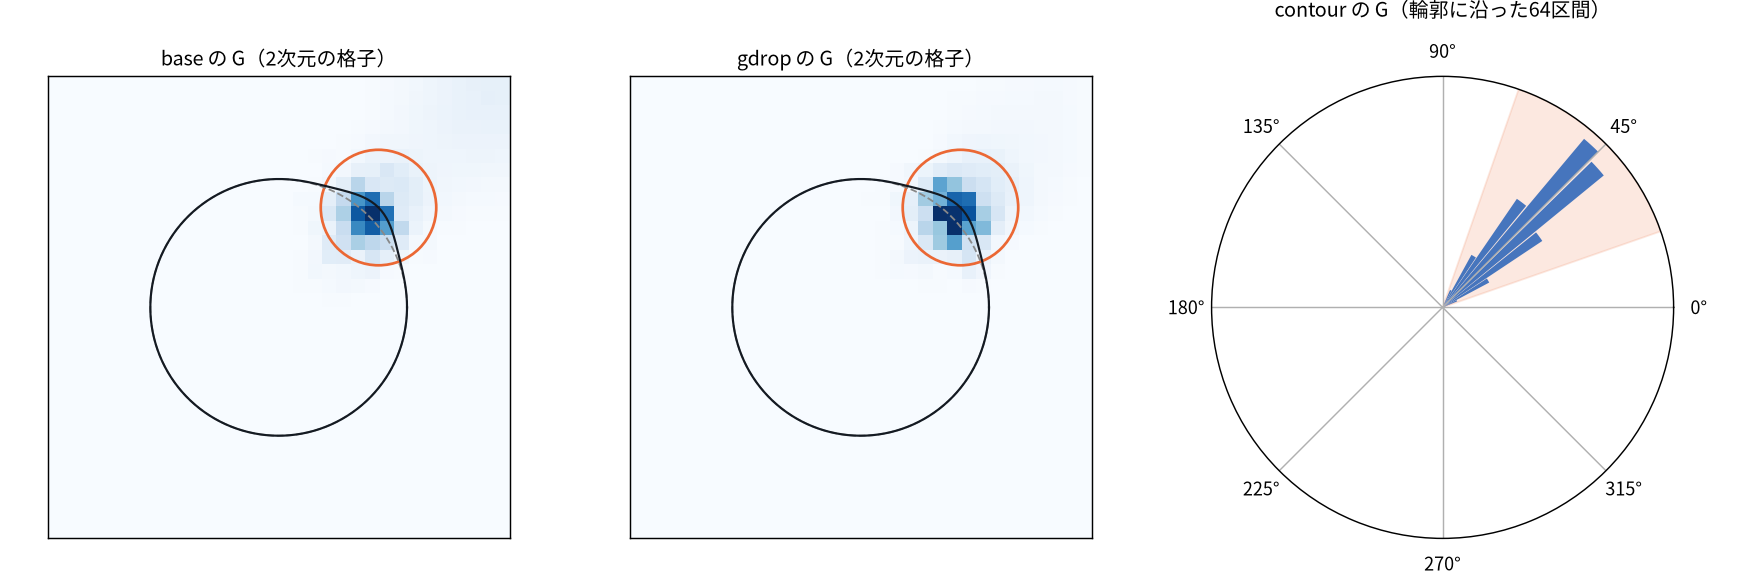
- 意図
性質5を確かめる.輪郭の一部を変える編集が,潜在の対応する部分だけを変えるか.
- 期待
変化が突起の近くに集まる.
- 結果
3つとも変化は突起の近くに集まった.範囲の外にもれた割合は base 20%,gdrop 11%,contour 0.5%(一様に散らばれば格子では約95%).contour は ±0.45 rad の内側に 99.5% が入った.
- 考察
contour が最も局所的.格子の G では突起の外側の空間(形の外)にも少し広がる.局所性が高いと,離れた2つの編集が干渉しにくく,足し算が成り立ちやすい(7.4節).
7.4 足し算になるか
- 意図
性質4を確かめる.離れた2つの突起を両方付けた形の潜在が,それぞれの移動の和で表せるか.
- 期待
どの案も目安(0.02)を下回る.
- 結果
4案とも目安を下回った(contour 0.0056,base 0.0071,global_only 0.0084,gdrop 0.0086).
- 考察
足し算はどの案でもほぼ成り立つ.ただしこれは「同じ形の上で」2つの編集を足す試験であり,別の形に編集を移せるかは別問題(7.5,7.6節).
7.5 同じ編集は,別の形でも同じ向きか
- 意図
性質3を確かめる.形の違う32個の基準形状に,まったく同じ突起(24種類)を付け,潜在の移動の向きがそろうかを cos 類似度で測る.
- 期待
同じ編集どうしは 1 に近く,対照(別の編集どうし)は 0 に近い.
- 結果
z_g で測った global_only 0.93 と gdrop 0.92 が高い.G で測った contour は 0.70,base は 0.38.対照はどれも 0 付近で,編集の種類は見分けられている.
- 考察
base の格子の G が低いのは,形の大きさが違うと同じ角度の突起でも入る格子のマスが変わるためと考えられる.contour は輪郭に沿った区間なので同じ場所に入るが,形の曲がり方の違いなどで向きが少しずれる.この時点では「gdrop が最良」に見えた.しかし向きがそろうことと,実際にその移動で形が変わることは別なので,次の実験で確かめた.
7.6 編集を別の形に移せるか(新しい実験)
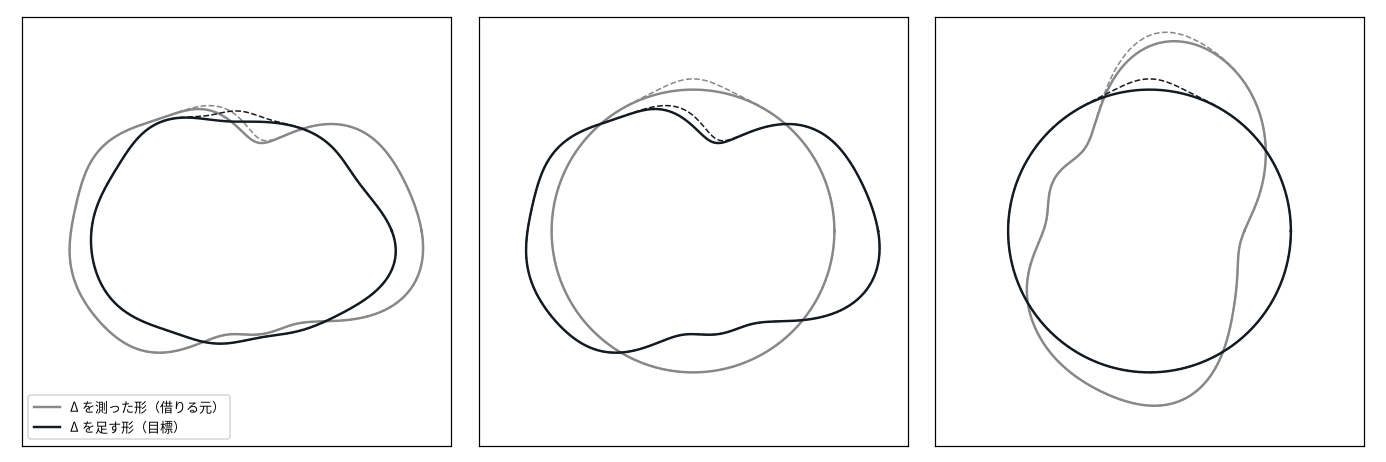
- 意図
性質3を「形に戻して」確かめる.形 A で測った編集の移動 Δ を,別の形 B の潜在に足して復号し,B に同じ突起が生えるかを見る.段階2では,まさにこの操作(潜在に Δ を足して形を作る)を使うので,最も実用に近い試験である.760通り(32形状×24編集のうち制約を満たすもの)で測った.
- 期待
7.5節で向きがそろった gdrop と global_only はうまく移せる.base は格子のずれで崩れる.contour はその中間.
- 結果
予想と大きく違った.誤差の中央値は contour 0.09,global_only 0.23,gdrop(G を消して z_g で)0.25,base 0.49,gdrop(G と z_g を移す)0.69,gdrop(z_g だけ移す)0.995.gdrop で z_g だけを動かしても,突起はほぼまったく生えなかった(図7-8 の青の実線はほぼ平ら).contour は位置も高さもほぼ正しい突起が生えた(図7-7).
- 考察
- gdrop の失敗の理由:G がある限り,復号器は細部を G から読み,z_g の変化をほとんど使わない.z_g の Δ は向きがそろっていても(7.5節),形を動かす力を持っていない.
- base・gdrop で G ごと移すと崩れる理由:格子の G では,A で測った変化が A の輪郭の位置のマスに入っている.B は輪郭の位置が違うので,ずれた場所に変化を足すことになる.
- global_only:移したときの誤差 0.23 のうち大半は,そもそもの再現の甘さ(直接符号化でも 0.14)による.
- contour:直接符号化の誤差 0.012 に対し移すと 0.09.まだ改善の余地はあるが,4案で唯一,再現と移しやすさを両立した.
- 教訓:潜在の数値だけを見る試験(cos 類似度)は,実際に形が変わるかを保証しない.判定には「形に戻して確かめる」試験が欠かせない.
次の実験:この「編集を移したときの誤差」を検査に正式に加え,学習中にも測る.contour の誤差を下げる工夫(区間数を128に増やす,区間の特徴を形の大きさで正規化する)を試す.
8.判定
| 基準 | 目安 | base | global_only | contour | gdrop |
|---|---|---|---|---|---|
| 評価セットの表面の誤差 | ≤ 2.5e-4 | 1.21×10⁻⁴ ✓ 合格 | 7.41×10⁻⁴ ✕ 不合格 | 2.37×10⁻⁴ ✓ 合格 | 1.47×10⁻⁴ ✓ 合格 |
| 別の形でも同じ向きか(cos) | ≥ 0.8 | 0.377 ✕ 不合格 | 0.931 ✓ 合格 | 0.699 ✕ 不合格 | 0.921 ✓ 合格 |
| 同(対照) | ≤ 0.1 | 0.002 ✓ 合格 | -0.068 ✓ 合格 | 0.001 ✓ 合格 | -0.067 ✓ 合格 |
| 合成の残差 | ≤ 0.02 | 0.007 ✓ 合格 | 0.008 ✓ 合格 | 0.006 ✓ 合格 | 0.009 ✓ 合格 |
| 線形性 R² | ≥ 0.99 | 0.9964 ✓ 合格 | 0.9999 ✓ 合格 | 0.9999 ✓ 合格 | 0.9998 ✓ 合格 |
| 【追加】編集を移したときの誤差(中央値) | ≤ 0.2(仮) | 0.487 ✕ 不合格 | 0.230 ✕ 不合格 | 0.092 ✓ 合格 | 0.995 ✕ 不合格 |
gdrop・global_only は z_g,base・contour は G で測った値.最後の行は今回追加した基準で,目安 0.2 は仮.gdrop の最後の行は「z_g だけ移す」の値.
- 意図
学習の前に決めた基準で,案を公平に選ぶ.
- 期待
contour と gdrop のどちらかが全基準に合格する.
- 結果
事前の基準では gdrop がすべて合格し,contour は「別の形でも同じ向きか」(0.70)だけ不合格だった.ところが追加した「編集を移したときの誤差」では,合格したのは contour だけで,gdrop は 0.99(突起が出ない)だった.
- 考察
事前の基準は,潜在の上の数値だけで「同じ向き」を測っており,その移動で形が実際に変わるかを見ていなかった.段階2で必要なのは「Δ を足すと狙った形になる」ことなので,追加した基準のほうが目的に直結する.提案:第一候補を contour に変更し,基準に「編集を移したときの誤差」を加える.
9.改良:編集を移しやすくする損失
8節で第一候補とした contour にも,編集を移すと 9% の誤差が残っていた.その出どころを調べ,学習のしかたを1つ足して改良した.
たとえ:ローポリの形と変位マップ
大域ベクトル z_g と空間潜在 G の関係は,ゲームの 3D モデルの「ローポリの形」と「変位(ディスプレースメント)マップ」の関係に似ている.大まかな形を少ない数で持ち,細かい凹凸を表面に沿った地図(テクスチャ)で足す.contour の G は,輪郭に沿った1次元の変位マップにあたる.
変位マップや法線マップには「オブジェクト空間」と「タンジェント空間」の2種類がある.前者は物体の座標で凹凸を書くので,別のモデルには貼り替えられない.後者は「その場の表面から見た」凹凸を書くので,別のモデルにも貼り替えられる.改良前の contour の G は前者に近く,同じ突起でも土台の形によって G の変化が違った.改良はこれを後者に近づけるものである.
9.1 誤差はどこから来るか(診断)
- 意図
改良前の contour で,移したときの誤差(9%)がどこから来るかを知り,直し方を決める.
- 期待
区間の数(64)が足りず,突起の細かい形を表しきれないなら,誤差は形の違いによらずほぼ一定になる.
- 結果
誤差は2つの形の半径の差とともに増えた(改良前の橙の棒:差が 0.05 未満で 0.051,0.5 以上で 0.311).ほかに,編集の情報はすべて G にあり(z_g だけ移すと誤差 1.00),突起の高さはほぼ合っていた(最もよく合う倍率の中央値 1.00).
- 考察
区間の数ではなく,「G の変化が土台の形に依存すること」が原因.同じ突起でも,半径の大きい形と小さい形とで G の変化が違う(オブジェクト空間の地図になっている).区間を増やしても直らないので,当初の案(区間を128に増やす,正規化)はやめ,「同じ編集なら G の変化も同じ」を直接学習させることにした.
9.2 改良の方法
学習の各 step で,学習用の基準形状から2つ(A と B)を選び,同じ突起 e を両方に付けた4つの形(A,A+e,B,B+e)をその場で作る(GPU で計算.正解の SDF は要らない).そして2つの G の変化 ΔA=G(A+e)−G(A) と ΔB=G(B+e)−G(B) のずれ ‖ΔA−ΔB‖² を,大きさ (‖ΔA‖²+‖ΔB‖²)/2 で割った値を損失に加える.大きさで割るので,「変化を小さくしてずれをごまかす」ことはできない.重みは 0.1 と 1.0 の2通りを,ほかは改良前と同じ条件(60,000 step)で学習した.
9.3 学習中の変化
- 意図
新しい損失で,移したときの誤差が実際に下がるか,学習のどの段階で下がるかを見る.
- 期待
改良前の 9% から 5% 以下に下がる.再現の誤差(点線)は少し悪くなるかもしれない.
- 結果
どちらの重みでも学習とともに下がり続け,最後は重み 0.1 で 0.017,重み 1.0 で 0.018.どの時点でも,移したとき(実線)と直接(点線)の差は小さい(最後で 0.004).
- 考察
予想を大きく上回った.移したときの誤差はほぼ「モデルの再現力の限界」まで下がり,残りの誤差は移すことではなく再現そのものから来ている.これ以上下げるには,再現の精度(区間の数や学習の長さ)を上げる必要がある.重み 0.1 と 1.0 でほぼ同じなので,重みは小さいほうで十分.
- 意図
9.3節の数字が,実際の突起の形として何を意味するかを1つの例で見る.
- 期待
改良後の線は,正解の破線にほぼ重なる.
- 結果
改良前は突起の高さは合うが,裾の形が崩れていた.改良後は正解とほぼ重なった.
- 考察
Δ を足すだけで,別の形にも同じ突起を生やせるようになった.段階2で「潜在に Δ を足して形を作る」操作の土台ができた.
9.4 代わりに失ったもの:編集の広がり
- 意図
改良の副作用を確かめる.局所性の値が 0.005 から 0.11 に悪くなったので,G の変化が実際にどう広がったかを見る.
- 期待
土台によらない変化にするために,G の変化が突起の外にも少し広がる.
- 結果
改良前は ±20° ほどに収まっていた(範囲の外は 0.5%).改良後は ±35° ほどまで裾が広がった(重み 0.1 で 11%,重み 1.0 で 19%).重み 1.0 では 45° より遠くにも薄く広がる.
- 考察
移しやすさと局所性の取り引きになっている.広がりは今のところ突起の近く(±35°)に留まり,足し算(合成の残差)はむしろ良くなった(下の表)ので,段階2を進めるうえで問題にはならないと考える.ただし,編集した範囲だけを計算し直して速くする(3次元や IDO の段階での高速化)には,広がりが狭いほど有利である.必要になったら,G の変化を突起の近くに収める項を損失に足して両立を試す.
9.5 比べた結果と判断
| 指標 | contour(改良前) | contour+移す損失(重み 0.1) | contour+移す損失(重み 1.0) |
|---|---|---|---|
| 編集を移したときの誤差(中央値)↓ | 0.092 | 0.017 | 0.018 |
| 同(25〜75%) | 0.055〜0.153 | 0.014〜0.022 | 0.015〜0.022 |
| 直接の再現の誤差(下限)↓ | 0.012 | 0.013 | 0.014 |
| 評価セットの表面の誤差↓(目安 2.5×10⁻⁴) | 2.37×10⁻⁴ | 2.82×10⁻⁴ | 1.92×10⁻⁴ |
| 別の形でも同じ向きか(cos)↑ | 0.699 | 1.000 | 1.000 |
| 合成の残差↓ | 0.0056 | 0.0008 | 0.0007 |
| 局所性(範囲の外にもれた割合)↓ | 0.005 | 0.110 | 0.185 |
↓は小さいほど良い,↑は大きいほど良い.どれも G で測った値.
- 意図
改良版を段階1のモデルとして採用してよいかを決める.
- 期待
移したときの誤差が下がり,再現の誤差は目安(表面の誤差 2.5×10⁻⁴)の近くに留まる.
- 結果
重み 0.1 の改良版は,移したときの誤差 0.017(改良前 337.500),表面の誤差 2.82×10⁻⁴(改良前 2.37×10⁻⁴),別の形でも同じ向きか 1.000(改良前 0.70.8節で唯一不合格だった基準).表面の誤差はわずかに目安を超え,局所性は悪くなった.
表面の誤差は学習の終わりでも測るたびに揺れる.最後の3回(50k〜60k step)の平均は,重み 0.1 で 2.74×10⁻⁴,重み 1.0 で 3.92×10⁻⁴.
- 考察
移したときの誤差は約5分の1になり,8節で不合格だった「別の形でも同じ向きか」も合格した.表面の誤差の超過(2.82×10⁻⁴)は学習の終わりの揺れの範囲内で,最小の突起(高さ 0.03)の約1/100にあたり,実用上は問題ないと考える.局所性の悪化は9.4節のとおり許容できる.重み 1.0 は,最後の1回の表面の誤差こそ小さいが,最後3回の平均では重み 0.1 より悪く,局所性も悪いので選ばない.表面の誤差は,学習を長くするか,検証の誤差が最良の時点のモデルを使うことで下げられる見込みがある.
選んだもの:段階1のモデルを「contour+編集を移しやすくする損失(重み 0.1)」(ae-20261120-1528-contour-tr01)とする.
10.外挿テスト:学習の範囲外の形でも使えるか
学習に使った形は「Fourier の次数 8 までの滑らかな形に,高さ 0.02〜0.12(土台の半径に対する比)の突起を付けたもの」に限られる.段階2以降で予測した編集が少し範囲を外れても,形が崩れないかを確かめる.データは学習の前に作っておいた2種類(3節)と,高さだけを細かく変えた形を使った.比べるのは改良前の contour と,9節で選んだ改良版(重み 0.1).
10.1 再現
- 意図
学習の範囲外の形を,そもそも正確に再現できるかを見る.再現が崩れれば,編集を移す試験も意味を持たない.
- 期待
高い突起(ood_h)は輪郭の一部が少し外れるだけなので,ほぼ落ちない.形の族が違う(ood_family)は,学習で見たことのない細かい波(次数 9〜12)を含むので,ある程度落ちる.
- 結果
改良版の表面の誤差は,学習と同じ範囲 5.69×10⁻⁴,突起が高い 5.91×10⁻⁴,形の族が違う 8.81×10⁻⁴(1.55 倍).改良前の contour は 5.47×10-4,5.59×10-4,7.52×10-4(1.37 倍).
- 考察
予想どおり.高い突起ではほとんど落ちず,形の族が違うと 1.4〜1.6 倍に悪くなる.改良版のほうが落ち方が少し大きいが,どちらも最小の突起(高さ 0.03)の約1/35〜1/40 で,形としては十分正確.なお,このデータの形は評価用の円柱(8節の目安 2.5×10⁻⁴)より複雑なので,学習と同じ範囲でも誤差はその約2倍になる.
10.2 編集を移す
- 意図
段階2で最も使う操作「潜在に Δ を足して形を作る」が,範囲外の形でも成り立つかを見る.
- 期待
再現と同じく,高い突起ではほぼ落ちず,形の族が違うと少し落ちる.改良版は改良前より全体に低い.
- 結果
改良版の誤差の中央値は,学習と同じ範囲 0.016,突起が高い 0.016,形の族が違う 0.023.直接符号化の下限はそれぞれ 0.011,0.010,0.015.改良前は 0.097,0.101,0.136.
- 考察
予想どおり.高い突起でも移しやすさは変わらない.形の族が違うと移したときの誤差は 1.5 倍になるが,その大半は再現そのものの落ち(下限も 1.5 倍)による.範囲外でも,改良版は改良前の「範囲内」の値よりずっと良い.改良の効果(同じ編集なら同じ変化)は,学習で見ていない形の族にも引き継がれた.
10.3 突起の高さを変える
- 意図
突起の高さ h をどこまで上げても正しく表せるか,学習の範囲の端で急に崩れないかを見る.
- 期待
学習の範囲の中では一定で,外に出ると(特に高い側で)誤差が増え,生えた突起の高さが本来より低くなる(頭打ち).
- 結果
h=−0.14〜+0.20 のどこでも,誤差はほぼ一定だった(改良版で移す 0.017〜0.019,改良前で 0.100〜0.109).生えた突起の高さの比も,どの h でも 1 からのずれが 0.8% 以内だった.
- 考察
予想と違い,学習の範囲の 1.5 倍の高さ(h=0.20)でも頭打ちにならなかった.contour の G は,輪郭の半径の変化をほぼ比例的に表していると考えられる(7.1節の比例の検査とも合う).凹みの側は,半径の下限(0.5)の制約のため −0.14 までしか試せていない.段階2で予測が多少大きめに外れても,形が壊れる心配は小さい.
10.4 まとめ
改良版は,高い突起には完全に,違う形の族にもおおむね外挿できた.弱点は「見たことのない細かい波を持つ形」で,再現が 1.5 倍ほど悪くなる.段階2・3はまず学習と同じ範囲の形で進め,形の族を広げるときは学習データに含めるのが安全である.
11.段階2:編集から潜在の変化を予測する
段階2では「編集前の形の潜在」と「編集の指定(どこに,どれくらいの突起)」から,編集後の形の潜在を予測するモデル(予測器)を作る.編集後の形を実際に作らなくても,新しい潜在が得られるようにするためである.設計の詳細と判断の経緯は状況ページの「段階2の設計」にある.
予測器が超えるべき基準:段階1で「同じ編集なら,どの形の上でも同じ ΔG」になったので,学習しなくても「半径1の円に同じ突起を付けて測った ΔG を足す」だけで予測できる.そこで2つの条件で試した.
- C1:高さを絶対量で指定する.学習なしの方法でもほぼ解けるので,仕組みが正しく動くかの確認.
- C2:高さを「土台の大きさ R0 に対する比」で指定する(例:「半径の 8% の突起」).実際の高さは土台によって変わる.R0 は予測器に与えず,潜在から読み取らせる.予測器に価値があるかの本試験.
予測器は小さな円環状の1次元畳み込み(0.54M パラメータ).符号化器と復号器は段階1の改良版で固定し,損失は潜在の上で取る.判定は必ず復号した形で行う.
11.1 予測の正確さ
- 意図
予測器が学習なしの方法を上回るか,合格の目安を満たすかを確かめる.
- 期待
C1 では学習なしの方法と同程度,C2 では学習なしの方法を大きく上回る.
- 結果
1回目は C1 0.025,C2 0.025 で,C2 は学習なし(0.055)の半分以下になったが,どちらも目安に届かず,C1 は学習なし(0.016)に負けた.設定を見直した2回目は C1 0.0131,C2 0.0129 で,両方とも目安を満たし,C1 でも学習なしの方法を上回った.下限(直接の再現)は 0.0111.
- 考察
2回目の予測器は,編集後の形を実際に作って符号化した場合とほぼ同じ正確さで潜在を予測できる.学習なしの方法との差は C1 では小さく,C2 では約4倍.予測器の価値は「指定の意味が土台によって変わる編集」で出る,という設計の見立てどおりになった.
- 意図
1回目と2回目の違いがどこから来たかを確かめる.
- 期待
1回目は学習が足りておらず,2回目は ΔG の誤差がさらに下がる.
- 結果
1回目は終わりの時点でも誤差が下がり続けていた.また損失の大半を zg の予測が占めていた(zg には編集の情報がほとんどなく,予測しにくい).2回目は zg の重みを 0.1 から 0.01 に下げ,学習を 2万から10万 step に延ばした(学習時間は約12分).ΔG の誤差は1回目の終わりの約 1/4 まで下がった.
- 考察
形を決めるのは G なので,G の予測に学習を集中させたのが効いた.合格の目安は学習の前に決めたものから変えていない.設定を変えた根拠は検証用の損失(学習が途中だったこと,zg の項が大半を占めていたこと)だが,1回目のテストの結果も見たうえでの見直しなので,2回目のテストの値はわずかに楽観的な可能性がある.設定は2通りしか試しておらず,その影響は小さいと考える.
11.2 予測器は土台の大きさを読めているか
- 意図
C2 で,予測器が潜在から土台の大きさ R0 を読み取って高さを正しく換算できているかを確かめる.
- 期待
学習なしの方法は R0 が 1 から離れるほど誤差が増える.予測器は R0 によらずほぼ一定になる.
- 結果
学習なしの方法は R0 が 1 に近いと 0.034,端では 0.079.予測器は 0.012〜0.014 でほぼ一定だった.
- 考察
予測器は,与えられていない土台の大きさを潜在から読み取り,「比」で与えた指定を実際の高さに換算できている.段階2の役割(土台の形に応じて編集の効き方を変える)を,この単純な例で確かめられた.より実際に近い「法線方向の押し出し」(C3)でも同じことが成り立つかは,次に決める.
11.3 2回続けた編集と外挿
- 意図
予測器を続けて使っても誤差が積み上がりすぎないか,学習の範囲外の形でも使えるかを見る.
- 期待
2回続けても単独の2倍以内.外挿では段階1と同じ程度に落ちる.
- 結果
2回続けて 0.0175(単独 0.0129,下限 0.0139).高い突起 0.0162(下限 0.0104),違う形の族 0.0186(下限 0.0153).どれも学習なしの方法(0.059,0.054,0.056)を大きく下回った.
- 考察
2回続けたときの下限との差は単独の約2倍で,2回分の予測の誤差が足された程度に収まる(誤差が増幅されて崩れることはない).予測した潜在を次の予測の入力にしても崩れないので,編集を重ねる使い方ができる.違う形の族では下限に近く,予測器そのものの落ちは小さい.高い突起では下限との差が少し広がる(学習で見た高さの外のため).
11.4 C3:法線方向に押し出す編集
実際の設計に近い編集として,輪郭の各点を外向きの法線方向に押し出す(例:「この面を 2 mm 押し出す」).押し出しの幅は輪郭に沿った長さで測る.円ではこれまでの「動径方向の突起」と同じになるが,土台が傾いている所では,同じ指定でも形の変わり方が違う(同じ基準形状で比べると中央値で 14%).予測器は,土台の傾きを潜在から読み取って,正しい形の変化を予測する必要がある.
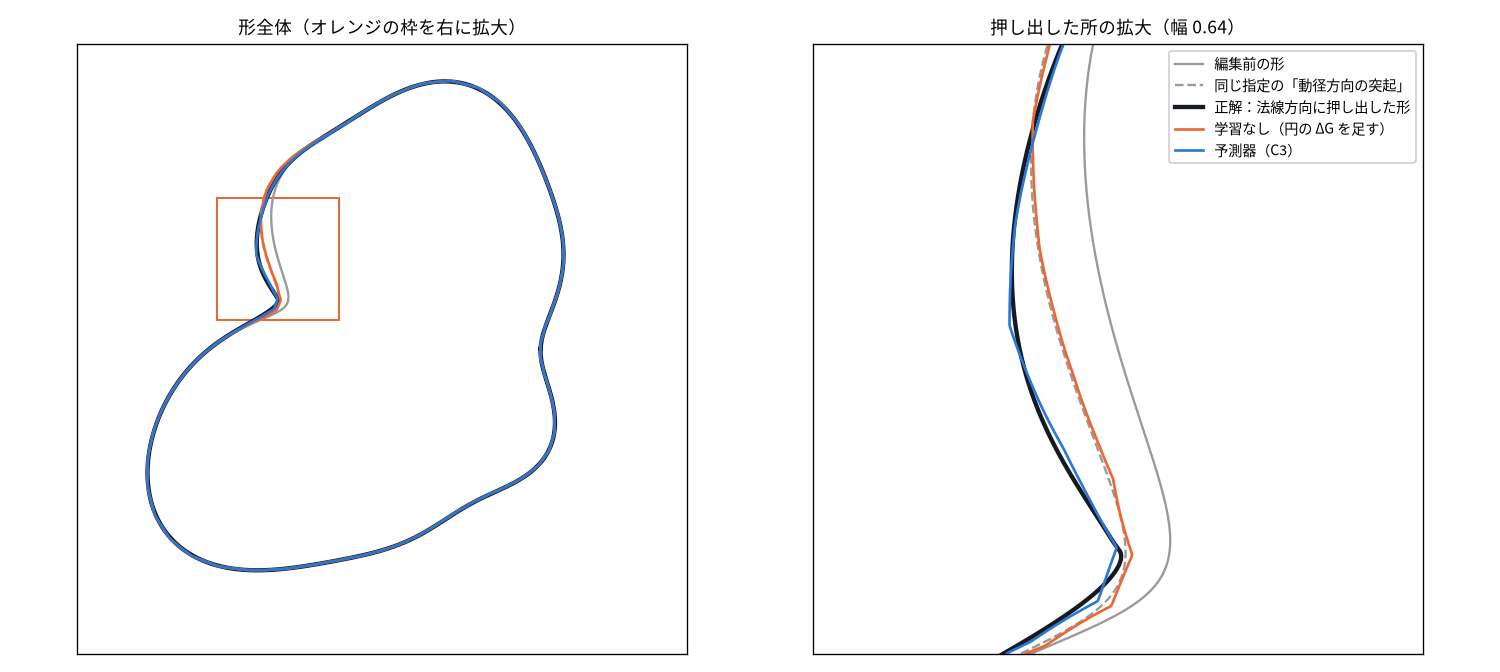
- 意図
C3 の編集が,学習なしの方法では表せず,予測器なら表せることを,1つの形で目で見て確かめる.
- 期待
学習なしの方法は円で測った変化を足すので,動径方向の突起(灰色の破線)に近い形になる.予測器は正解(黒)に近い形になる.
- 結果
そのとおりになった.拡大図で,オレンジは破線に,青は黒にほぼ重なる.押し出しの位置と向きが,傾きによって動径方向とずれていることも見てとれる.
- 考察
学習なしの方法の弱点は「円で測る」ことにあり,土台の傾きを知らない.予測器は潜在から傾きを読み取っている.この例は数ある組の1つなので,全体の傾向は次の図で確かめる.
- 意図
C3 で予測器が学習なしの方法を上回るか,学習の前に決めた目安(0.02 以下)を満たすかを確かめる.
- 期待
学習なしの方法は誤差 0.14 前後と大きく,予測器はそれを大きく下回って目安を満たす.
- 結果
テストで予測器 0.0175,学習なし 0.140,下限 0.0136.2回続けて 0.0238(下限 0.0208),高い押し出し 0.0206,違う形の族 0.0289(下限 0.0199).
- 考察
目安を満たし,学習なしの方法より約 8 倍正確.C2 より土台への依存が強い編集でも,予測器は直接符号化した場合に近い正確さを保った.違う形の族では落ちが大きめ(下限との差 0.009)で,見たことのない細かい波の上の傾きは読み取りにくいと考えられる.C3 は C2 の2回目と同じ設定で,1回で決めた(結果を見て設定を変えていない).
11.5 判定
| 検査 | 目安(学習の前に決めた) | 採用した設定での値 | 判定 |
|---|---|---|---|
| 予測の誤差(C1) | ≤ 0.015 | 0.0131 | ✓ 合格 |
| 予測の誤差(C2) | ≤ 0.02 | 0.0129 | ✓ 合格 |
| 2回続けた予測(C2) | ≤ 単独の2倍(0.026) | 0.0175 | ✓ 合格 |
| 外挿:高い突起(C2) | 下限の落ちと同程度 | 0.0162 | 記録のみ |
| 外挿:違う形の族(C2) | 下限の落ちと同程度 | 0.0186 | 記録のみ |
| 予測の誤差(C3) | ≤ 0.02 | 0.0175 | ✓ 合格 |
| 2回続けた予測(C3) | ≤ 単独の2倍(0.035) | 0.0238 | ✓ 合格 |
選んだもの:段階2の予測器を2回目の設定(zg の重み 0.01,10万 step)とする.編集の指定の種類ごとに予測器を1つずつ持つ(C2 用 pred-20261120-1646-c2-v2,C3 用 pred-20261120-1704-c3).
12.段階3:あり得る形の変化を分布として出す(cINN)
段階2の予測器は,指定から「1つの答え」を出す.しかし「このあたりに突起を付けたい」のように指定が大まかなときは,あり得る形が幅を持って存在する.段階3では,その幅を確率の分布として学び,候補をいくつでも取り出せる(サンプリング)ようにする.将来は条件を「望む流れの変化」に替えて,逆設計(流れの目標から形の候補を出す)に使う.
- 条件:土台の形,45° 単位の大まかな場所(区画),突起か凹みか.区画の中の位置,高さ,幅は決まっていない.
- 分布を学ぶもの:ΔG を「区画の中心で向きをそろえて,主成分 24 個に要約したもの」(情報の 99.99%).要約の数は,形に戻して誤差を測って決めた(状況ページの「段階3の設計」).
- モデル:条件付きのアフィン結合層を8段重ねた cINN(1.05M パラメータ,学習は約2分).学習のときだけ,要約した数に小さな雑音(標準偏差 0.05)を足す(12.4節).比較は「突起か凹みかごとの正規分布(平均と共分散だけ)」.
- 評価:サンプルを形に戻して1つの突起を当てはめ,指定どおりか,位置・高さ・幅の分布が学習データと合うかを見る.当てはめそのものの精度は,正解の編集で確かめた(位置の誤差 0.25°,高さ 0.0006,幅 0.14°).
12.1 サンプルは指定どおりの突起になるか
- 意図
cINN から取り出した候補が,実際に「指定の場所に,指定の向きの,突起らしい形」になっているかを確かめる.
- 期待
cINN はほぼすべて指定どおり(目安 90% 以上).正規分布は,いろいろな突起を平均したぼやけた形が出て,突起らしさで落ちる.
- 結果
cINN 96.6%,正規分布 33.1%.正規分布は場所(96%)と向き(96%)はおおむね合うが,当てはめの残差の中央値が 26% と大きく(cINN は 3.3%,正解は 2.1%),突起らしい形にならない.
- 考察
予想どおり.あり得る突起の集まりは,24 次元の中で位置・高さ・幅の3つの自由度が作る曲がった面になっている.正規分布はその「平均の近く」をぼんやり覆うだけで,面の外(どの突起でもない形)を多く出す.cINN はその面の上に分布を載せられている.
12.2 ばらつきは学習データと合うか
- 意図
候補の幅(どんな位置・高さ・幅が,どれくらいの頻度で出るか)が,学習データの分布と合うかを確かめる.
- 期待
cINN の分布は正解とほぼ重なる.正規分布は形が崩れるぶん,当てはめた値の分布もずれる.
- 結果
正解との距離(範囲で割った値,目安 0.1 以下)は,cINN が位置 0.019,高さ 0.023,幅 0.031.正規分布は 0.032,0.076,0.167.cINN の高さの中央値は 0.065 で,正解は 0.070(比 0.93).
- 考察
位置・高さ・幅のどれも,cINN は正解とよく合う.最初の設定では高さが低めに偏っていた(距離 0.099,中央値の比 0.77)が,学習時に雑音を足す改良(12.4節)で直った.正規分布は幅の分布が大きくずれる.正規分布の値は崩れた形に無理に当てはめたものなので,cINN と同じ土俵では比べられない(12.1節).
- 意図
同じ指定から何度も取り出したとき,候補が「いろいろな,しかしどれも妥当な」形になるかを目で見る.
- 期待
cINN の候補は位置・高さ・幅がばらつくが,どれも1つのきれいな突起.正規分布の候補は,形が崩れたり,区画の外に広がったりする.
- 結果
そのとおりになった.cINN の8つはどれも1つの山で,位置・高さ・幅がそれぞれ違った(高さはおよそ 0.05〜0.13).最初の設定では,ほとんど平らな低い山が混じっていたが,改良後は見られない.正規分布の8つは,山のあとに谷が続く(突起と凹みが混ざった)形や,裾が波打つ形が多かった.
- 考察
cINN は「答えが1つに決まらない指定」に対して,妥当な候補を幅を持って出せる.段階2の予測器(1つの答え)と組み合わせると,大まかな指定 → cINN で候補を複数 → 各候補の形と(将来は)流れを比べる,という使い方ができる.
12.4 高さの偏りを直す
最初の設定(cinn-20261120-1720-a)は目安をすべて満たしたが,高さが低めに偏っていた(12.2節).原因を調べ,直し方を4通り比べた.直し方の選択には検証用の組だけを使い,テスト用の組では採用した1つだけを測った(この節の図はすべて検証用の値).
- 意図
高さの偏りの原因が「要約(主成分)」にあるのか,「cINN の学習」にあるのかを切り分ける.
- 期待
要約は正解の高さをほぼ保つ(正解の ΔG を要約して戻しても高さの分布の距離は 0.001 程度)ので,原因は学習の側にある.学習データに合わせ込みすぎる(過学習)と,見たことのない条件で崩れたサンプルが出やすい.
- 結果
学習用の組の値は最後まで下がり続け(-2.22),検証用の組の値は 13,000 step で最良(-1.59)になった後,最後には -1.33 まで悪化した.学習用と検証用の差は約 0.9.最初の評価は最後の重みを使っていた.
- 考察
過学習している.あり得る突起は,24 次元の中で位置・高さ・幅の3つの自由度が作る薄い面の上にある.薄い面に確率を載せる学習は,面の厚みをどこまでも薄くすれば値が良くなるため,学習データの点に張り付きやすい.対策として,(1) 検証が最良の時点の重みを使う,(2) モデルを小さくして重み減衰を強める,(3) 学習のときだけ要約した数に小さな雑音を足して面に厚みを持たせる,を比べる.
- 意図
4通りの直し方のうち,指定どおり率を保ったまま高さの偏りを直せるものを選ぶ.
- 期待
(3) 雑音を足すのが最も効く.雑音は薄い面に厚みを与え,張り付きを防ぐ.ただし雑音が大きすぎると,面の外の形(突起らしくない形)も出るようになり,指定どおり率が下がる.(1) と (2) は過学習を少し抑えるだけで,偏りは残る.
- 結果
高さの中央値の比(1 なら偏りなし)は,そのまま 0.79,小さく+重み減衰 0.72,雑音 0.05 で 0.97,雑音 0.1 で 1.00.指定どおり率は順に 97.8,97.3,95.8,90.1%.
- 考察
予想どおり.雑音 0.05 は,高さの偏りを直しながら,指定どおり率を目安(90%)より十分上に保った.雑音 0.1 は偏りが最も小さいが,指定どおり率が目安ぎりぎりまで下がった.(1) は検証の値が最良の時点でも高さが低いままで,確率の値(NLL)が良いことと,サンプルの形が良いことは一致しない.そのため雑音を足したモデルは NLL が最初の設定より悪くなるが(雑音でぼかした分布を学ぶため),正規分布よりはずっと小さい.設定の選び方は,NLL ではなくサンプルを形に戻した検査で決めるのがよい.
12.5 判定
| 検査 | 目安 | cINN(採用) | cINN(最初の設定) | 正規分布 | 判定(採用) |
|---|---|---|---|---|---|
| 指定どおり率 | ≥ 90% | 96.6% | 97.6% | 33.1% | ✓ 合格 |
| 分布の一致:位置 | ≤ 0.1 | 0.019 | 0.022 | 0.032 | ✓ 合格 |
| 分布の一致:高さ | ≤ 0.1 | 0.023 | 0.099 | 0.076 | ✓ 合格 |
| 分布の一致:幅 | ≤ 0.1 | 0.031 | 0.062 | 0.167 | ✓ 合格 |
| 負の対数尤度(1次元あたり) | 正規分布より小さい | -1.17 | -1.27 | 1.41 | ✓ 合格 |
| 【追加】高さの中央値の比 | 0.9〜1.1 | 0.93 | 0.77 | 0.86 | ✓ 合格 |
目安は学習の前に決めたもの.【追加】は最初の設定の結果を見た後に加えた検査.値はすべてテスト用の組.
選んだもの:段階3のモデルを,学習時に雑音 0.05 を足した cINN(cinn-20261120-2113-c-noise05)とする.検証用の組で4通りから選び,テスト用の組では選んだ1つだけを測った.
13.まとめ
やったこと
- 編集の正解がわかる2次元の形のデータ(約7.9万形状)と,評価用の形(73個)を作った.
- 形を数の並びに変えて戻すモデルを4種類学習し,再現の正確さと,潜在が編集をどう表すかを6つの観点で調べた.
- 新しく「編集を別の形に移す」実験を行い,それを正式な検査に加えた.
- その誤差の出どころを調べ,contour を改良した(9節).
- 学習の範囲外の形(高い突起,違う形の族)で,再現と編集を移す性能を測った(10節).
- 段階2の予測器を作り,学習なしの方法と比べた(11節).
- 段階3の cINN を作り,大まかな指定から形の変化の候補を分布として出せるかを確かめた(12節).
わかったこと
- 形の再現はどの案でも十分正確(最小の突起の 1/40〜1/250 の誤差).
- 「大きさに比例」「足し算」は4案とも成り立つ.
- 差が出るのは「同じ編集を別の形に移せるか」.輪郭に沿って情報を持つ contour だけが,再現と移しやすさを両立した(移した誤差 9%).
- 潜在の数値だけで判定すると誤る.gdrop は数値上は最良だったが,z_g を動かしても形が変わらなかった.
- contour の残りの誤差は「G の変化が土台の形に依存すること」から来ていた.同じ編集なら同じ変化になるよう学習させると,移した誤差は 9% から 1.7% に下がり,モデルの再現力の限界にほぼ届いた.代わりに編集の影響が少し広がった.
- 改良版は,学習の範囲の 1.5 倍の高さの突起まで誤差が変わらず,違う形の族でも編集を移す性能はおおむね保たれた(再現は 1.5 倍ほど悪くなる).
- 段階2の予測器は,編集後の形を作らずに,直接符号化した場合とほぼ同じ正確さで潜在を予測できた.効き方が土台によって変わる編集では,学習なしの方法より大幅に正確だった(高さを土台の大きさに対する比で指定:約4倍,法線方向の押し出し:約8倍).土台の大きさや傾きを潜在から読み取れている.2回続けて使っても崩れない.
- 段階3の cINN は,大まかな指定(場所の区画と,突起か凹みか)から,97% が指定どおりの突起になる候補を出せた.正規分布では 33%.位置・高さ・幅のばらつきも学習データとよく合う.最初は過学習で高さが低めに偏ったが,学習のときに小さな雑音を足すと直った.確率の値(NLL)が良いことと,サンプルの形が良いことは一致しないので,設定はサンプルを形に戻した検査で選ぶ.
決まったこと
- 第一候補を contour とし,星状形状の前提を受け入れる(初期検討として手法の効果を確かめるため).
- 段階1のモデルは,改良版(contour+編集を移しやすくする損失,重み 0.1)とする.
- 段階2の主な試験は C2(高さを土台の大きさに対する比で指定),符号化器は固定.予測器は2回目の設定とする.C3(法線方向の押し出し)も同じ設定で合格した.
- 段階3は,ΔG を区画の中心で向きをそろえて 24 個の数に要約し,その分布を cINN で学ぶ.学習のときに要約した数へ雑音(標準偏差 0.05)を足す.
次の実験(優先順)
- 土俵の中の答え合わせ(
docs/evaluation-plan-beyond-fourier-2026-11-20.md).学習データを作ったフーリエ係数そのものと比べる.段階2・3も,単純な対抗馬(MLP 回帰,編集してから符号化し直す素朴な方法,混合ガウス)と比べる. - 土俵の外の評価セット(角のある形,星状でない形)を用意し,今のモデルにそのまま通して,どこで何が崩れるかを見る.
- 流れ場(IDO)に進むか決める.段階1〜3の形の部分はそろったので,評価用の円柱+突起の形で流れを計算し,条件を「望む流れの変化」に替えた逆設計を試せる.
- 形の族を広げるときは,その族を学習データに含める(外挿では再現が 1.5 倍ほど悪くなるため).
- 必要になったら,局所性と移しやすさの両立(G の変化を突起の近くに収める項)を試す.
付録:学習したモデル
4節の4つの案(base,global_only,contour,gdrop)を,同じデータ・同じ手順で1本ずつ学習した.下の表はその記録である.
- 実行 ID:学習1回ごとの名前(ae-開始日時-案の名前).学習の記録とパラメータは
runs/のこの名前のフォルダにある. - パラメータ数:モデルの大きさ(2節).global_only は G を作る部分がないぶん小さい.
- 状態:学習の結果.「最良の検証損失」は,学習中に検証用の形で測った SDF の誤差の最小値.
| 案 | 実行 ID | パラメータ数 | 状態 |
|---|---|---|---|
| base | ae-20261119-1718-base | 1.39M | 60,000 step 完了,最良の検証損失 0.00077,所要 30 分 |
| global_only | ae-20261119-1718-global_only | 0.90M | 60,000 step 完了,最良の検証損失 0.00340,所要 24 分 |
| contour | ae-20261119-2319-contour | 1.20M | 60,000 step 完了,最良の検証損失 0.00101,所要 28 分 |
| gdrop | ae-20261119-2319-gdrop | 1.39M | 60,000 step 完了,最良の検証損失 0.00102,所要 31 分 |
図とグラフは scripts/progress_compute.py(学習済みのモデルから計算)と scripts/build_progress.py(このページ)で作り直せる.